Como Investigar uma URL: A Anatomia do Link que Revela Tecnologia, Estrutura e Falhas de um Site
Capítulos
8 seçõesNeste artigo
- O que você vai aprender neste aulão
- O que é uma URL e por que ela revela tanto
- Protocolo e domínio: as primeiras pistas do endereço
- Subdomain takeover: a falha grave escondida nos subdomínios
- O caminho da URL: lendo as pastas do servidor
- Query string: os parâmetros que expõem a lógica da aplicação
- Como proteger a sua aplicação dos abusos de URL
- O padrão da URL como pivô de busca
- Ferramentas e Referências Citadas Neste Aulão
- Perguntas Frequentes
- Referências e Recursos
O que você vai aprender neste aulão
Aprender como investigar uma URL é uma daquelas viradas de chave que mudam para sempre o jeito que você usa a internet. Nesse aulão eu passei mais de uma hora ao vivo destrinchando a anatomia de um link, porque por trás daquele endereço que você clica sem pensar existe uma quantidade enorme de informação sobre o alvo: a tecnologia que ele usa, os subdomínios que ele esconde, a estrutura de pastas do servidor e a lógica da aplicação.
Depois de ler, você nunca mais vai olhar uma URL da mesma forma. Vou explicar cada parte do link (protocolo, subdomínio, domínio, caminho e parâmetros) e o que cada uma revela numa investigação, incluindo falhas famosas como o subdomain takeover e o acesso indevido a objetos por ID. E vou fechar com o lado defensivo: o que o desenvolvedor precisa validar para que a URL do seu sistema não vire uma porta escancarada.
Eu digo sempre que muito do meu sucesso nos desafios de investigação vem justamente de saber ler uma URL. Não é sobre ser genial, é sobre pensar em possibilidades a cada elemento do endereço. Essa aula compartilha esse fundamento, que eu considero obrigatório para qualquer investigador digital.
Quando as pessoas se impressionam com um desafio de investigação que eu resolvo, elas costumam achar que é talento. Não é. É método: eu olho para a URL e, em vez de ver um link, vejo uma lista de perguntas. Que tecnologia é essa? Que subdomínios existem? Essa pasta abre? Esse parâmetro pode ser mudado? Cada pergunta é uma porta, e a maioria das portas está fechada. Mas basta uma abrir para o caso andar, e é isso que essa aula te ensina a enxergar.
O que é uma URL e por que ela revela tanto
Uma URL é o Localizador Uniforme de Recursos, o endereço que aponta para uma página, um documento ou um serviço na internet. É o texto que você digita na barra do browser. Até aí, nada de novo. A documentação da MDN cobre bem essa definição básica.
O que muda tudo é encarar a URL não como um texto que você digita, mas como um mapa da aplicação. Cada parte do endereço carrega uma pista. O protocolo diz como você acessa. O subdomínio e o domínio dizem quem é o alvo e como ele se organiza. O caminho revela a estrutura de pastas do servidor. E os parâmetros expõem a lógica interna da aplicação.
Um site pode, através da URL, entregar a tecnologia que usa, os softwares que acompanham a empresa, nomes de documentos e usuários, subdomínios, aplicações de parceiros e até falhas de segurança. É por isso que a interpretação de URL é a base de qualquer investigação de site, o mesmo espírito do aulão sobre técnicas para investigar sites.
Protocolo e domínio: as primeiras pistas do endereço
O começo da URL, o protocolo e o domínio, já dá as primeiras informações sobre o alvo. O protocolo mais comum é o HTTPS (a versão criptografada do HTTP), mas existem outros que aparecem em links: o mailto: que abre o cliente de e-mail, o ftp: de transferência de arquivos. Reconhecer o protocolo é o primeiro reflexo ao ler um endereço.
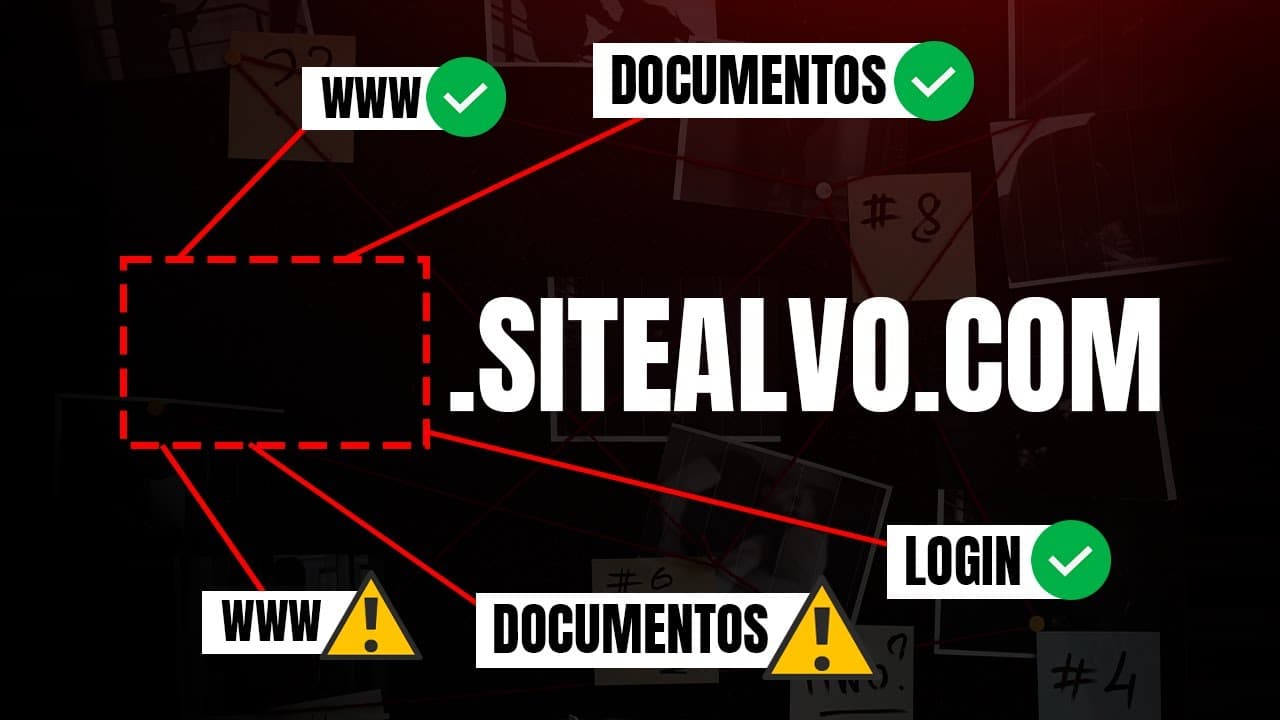
Depois vem a estrutura do domínio. O .com, .net, .br é o domínio de topo (top level domain). O que vem antes é o domínio de segundo nível, o nome registrado da empresa. E antes dele pode haver um subdomínio. Um detalhe que muita gente não sabe: o www também é um subdomínio, e ele pode apontar para um lugar diferente do domínio principal.
O subdomínio é onde a investigação começa a ficar interessante. Sempre que eu vejo um subdomínio numa URL, eu tento encontrar os outros subdomínios daquele site, porque cada subdomínio novo aumenta o escopo da investigação. É exatamente a técnica que eu detalho no aulão sobre subdomínios escondidos, e ela se conecta com outros pivôs de infraestrutura, como o do aulão sobre favicon.
Subdomain takeover: a falha grave escondida nos subdomínios
O subdomain takeover é uma das falhas mais comuns e mais graves ligadas a subdomínios, e ela nasce de um apontamento esquecido. Empresas criam subdomínios (como blog.empresa.com ou lp.empresa.com) que apontam, via CNAME, para serviços externos contratados: um Webflow, um LeadPages, uma área de membros. O apontamento fala "esse subdomínio é servido por aquele serviço".
O problema aparece quando a empresa cancela o serviço, mas esquece de remover o apontamento no DNS. O subdomínio continua apontando para um serviço que não tem mais dono. Aí outra pessoa cria uma conta naquele serviço, reivindica aquele endereço e passa a controlar o subdomínio da empresa. Ela sequestra o subdomínio para a conta dela.
Isso não é raro: em plataformas de bug bounty como a HackerOne, empresas pagam recompensas por essa falha todo dia, tema que eu toquei no aulão sobre bug bounty. Existe até um projeto no GitHub, o can-i-take-over-xyz, que cataloga quais serviços são vulneráveis e as mensagens de erro que denunciam a falha. Quando você abre um subdomínio e vê "conta não encontrada" num serviço SaaS, é um sinal clássico.
Por que essa falha é tão perigosa? Porque o subdomínio sequestrado carrega a confiança da marca. Um golpe hospedado em blog.empresa.com engana muito mais que o mesmo golpe num domínio aleatório, porque a vítima vê o nome da empresa no endereço e baixa a guarda. O atacante usa o subdomínio legítimo para phishing, para roubar cookies de sessão ou para distribuir conteúdo malicioso, tudo sob a bandeira de quem foi descuidado com o DNS. Por isso o inventário de subdomínios não é curiosidade, é higiene de segurança que toda empresa deveria fazer com frequência.
A defesa é simples de dizer e fácil de esquecer: sempre que você para de usar um serviço externo, remova o apontamento DNS correspondente. Um CNAME órfão é um subdomínio à venda para qualquer um.
O caminho da URL: lendo as pastas do servidor
O caminho (path) da URL é a estrutura de pastas do servidor, e você pode lê-lo como o gerenciador de arquivos do seu computador. Assim como no seu computador o caminho até uma imagem passa por usuário, área de trabalho e pastas, num site o caminho passa pelos diretórios da aplicação. Você lê os nomes das pastas e dos arquivos direto na URL.
Isso revela mais do que parece. Um caminho como /arquivos/banners/2022/dezembro/imagem.png já diz que existe uma pasta de banners, organizada por ano e mês. Um caminho com wp-content denuncia na hora que o site roda WordPress. E conhecer a tecnologia abre portas: sabendo que é WordPress, você sabe onde fica a página de login padrão e conhece falhas conhecidas, como o endpoint que lista os usuários do site. Tudo isso partindo só da leitura da URL, o mesmo raciocínio de descoberta do aulão sobre Google Hacking.
Um hábito que eu recomendo é tentar "subir" no caminho, apagando o nome do arquivo para ver a pasta. Às vezes o servidor bloqueia (retorna acesso negado), às vezes ele lista o conteúdo do diretório inteiro, um problema de configuração conhecido como directory listing. O OWASP documenta esse risco como Path Traversal. Do lado da defesa, a lição para o desenvolvedor é clara: desabilite a listagem de diretórios e nunca confie que uma pasta está segura só porque ninguém tem o link dela.
Esse trabalho de "subir" e testar sempre revela algo? Nem sempre. Boa parte das tentativas dá acesso negado, e está tudo certo, é o servidor bem configurado. Mas quando você encontra um diretório aberto, uma pasta de uploads listando arquivos, um script exposto ou um arquivo de configuração baixável, o achado costuma valer o esforço. É por isso que eu insisto: encare o caminho como pasta e teste, porque o custo de tentar é zero e o retorno de um único acerto é enorme.
E aqui há uma pista de tecnologia que eu uso muito. Uma barra invertida com C:\ no caminho denuncia um servidor Windows. Uma pasta wp-content denuncia WordPress. Nomes de pastas como config, backup, uploads ou admin dizem onde a aplicação guarda o que importa. Cada nome é uma informação, e o investigador atento monta o perfil do servidor só juntando esses fragmentos, antes de tocar em qualquer parâmetro.
Query string: os parâmetros que expõem a lógica da aplicação
Depois da interrogação na URL vêm os parâmetros de query string, e é aqui que mora o poder de verdade. Esses parâmetros são valores que você envia para a aplicação, e boa parte deles é interpretada pelo servidor. Você fala quem você é, o que você quer, qual a data, qual o pedido. Ler e entender esses parâmetros é uma das coisas mais valiosas de uma investigação.
O exemplo que eu mostrei ao vivo foi de uma passagem: a URL trazia uma data como parâmetro. Mudar a data na URL mudava a busca no site. E aí surge a pergunta que separa o investigador do usuário comum: o que acontece se eu enviar um valor que a interface não oferece? Um dev cuidadoso valida a data no servidor. Um dev descuidado confia no que a tela mostrou, e o valor manipulado passa. É a chamada falha de lógica de negócio.
O caso mais didático é o do identificador. Quando uma URL tem um parâmetro como id=1, trocar para id=2 pode te dar acesso ao objeto de outro usuário, se a aplicação não checar a permissão. É a falha conhecida como IDOR (referência insegura a objeto direto). E há a variação de business logic: uma URL que carrega o plano ou o preço, se não for validada no servidor, pode ser alterada para um plano superior. Para entender como uma aplicação lê esses parâmetros por dentro, eu montei uma pequena aplicação em Flask ao vivo, o tipo de exercício que eu ensino no aulão sobre programação do zero.
E o que a aplicação Flask deixou claro é assustador na simplicidade. Quando a rota recebe o valor da query string, o programador pode fazer o que quiser com ele: uma busca, um cálculo, uma consulta ao banco. Na pior das configurações, o valor da URL chega até uma execução de comando no servidor, e um simples ls digitado no parâmetro roda no sistema. Isso é o extremo do descuido, mas ilustra a regra: tudo que você envia pela URL pode ser interpretado por dentro, não fica só no que a página mostra.
Mas o ponto que eu quero que fique é o mais comum, não o mais raro. A maioria dos abusos de parâmetro não é execução de comando exótica, é business logic banal: um ID que dá no objeto errado, uma data que a interface não deixava escolher, um plano premium acessado por quem pagou o básico porque o servidor confiou na tela. São falhas de validação, e é justamente nelas que o investigador atento e o defensor competente concentram a atenção.
Como proteger a sua aplicação dos abusos de URL
Do lado do desenvolvedor, a URL é uma superfície de ataque que precisa de validação em cada parte. Todo o poder investigativo que eu descrevi vira risco quando a sua aplicação confia na entrada do usuário. A regra de ouro é nunca confiar no que vem pela URL, porque o usuário controla cada caractere dela.
Estes cuidados concretos resolvem a maior parte dos problemas:
- Valide toda entrada no servidor, nunca só na interface. Data, ID, plano, preço: o servidor precisa reconferir cada valor, porque a tela pode ser contornada.
- Cheque permissão em cada objeto acessado por ID. Antes de devolver o pedido
id=2, confirme que o usuário logado tem direito àquele objeto. É a prevenção de IDOR que o OWASP detalha. - Desabilite a listagem de diretórios e proteja arquivos sensíveis (configurações, backups, scripts) para que não sejam baixáveis pela URL.
- Remova apontamentos DNS órfãos assim que cancelar um serviço externo, para não deixar subdomínios sequestráveis.
- Nunca passe segredo em query string. Parâmetros ficam em logs, no histórico e no referer, então token e senha não podem viajar na URL.
E OWASP é a referência que eu mando todo desenvolvedor estudar nesse ponto, porque cada uma dessas falhas tem um guia de prevenção detalhado lá. E HackerOne mostra o outro lado da moeda: o que não é validado vira recompensa paga a quem reporta. Ler os dois, o guia de defesa e os relatórios de falha, é o atalho mais rápido para escrever aplicação segura.
Mas nenhuma dessas defesas funciona se a validação ficar só no front-end. A tela é uma sugestão, não uma barreira: o usuário controla a URL inteira e pode enviar o que quiser, do jeito que quiser. E o recado vale para os dois lados. O investigador lê a URL para descobrir; o desenvolvedor lê a URL para se defender. É o mesmo conhecimento, usado com propósitos opostos.
O padrão da URL como pivô de busca
Uma URL não revela só um alvo, ela revela um padrão que aponta para dezenas de alvos parecidos. Quando você identifica uma estrutura de URL específica de um software (um parâmetro incomum, um caminho característico), você pode pesquisar esse padrão no Google e encontrar todos os outros sites que rodam o mesmo sistema. Um parâmetro como departureDate ou documentId vira uma dork que lista dezenas de aplicações com a mesma tecnologia.
Isso amplia a investigação de um jeito parecido com o favicon: você parte de um detalhe estrutural e chega a uma família inteira de sites relacionados. É uma forma de mapear quem usa determinado software, útil tanto para inteligência quanto para checar se a sua própria tecnologia está exposta em padrões previsíveis.
E há um uso investigativo direto nesse padrão. Se você encontra uma falha num software específico e sabe reconhecê-lo pela URL, a mesma dork lista dezenas de outras instalações que provavelmente compartilham a falha. Para o defensor, o raciocínio se inverte: se o meu sistema é reconhecível por um padrão de URL, um atacante encontra todas as minhas instâncias com uma única busca. Padronização traz conveniência, mas também previsibilidade, e previsibilidade é exatamente o que a investigação explora.
E Burp Suite é o próximo passo natural, que eu só mencionei no aulão. Nem tudo trafega no endereço visível. Uma requisição POST envia dados no corpo, invisível na barra do browser, e é aí que entra um proxy como o Burp Suite, que deixa você ver e alterar a requisição inteira. A URL é a porta de entrada do raciocínio, mas o mesmo pensamento de manipular valores se estende a tudo que a aplicação recebe.
Vale a pena aprender isso mesmo sem querer virar hacker? Com certeza. Interpretar URL te deixa mais seguro como usuário, porque você reconhece um link suspeito, entende para onde um parâmetro te leva e percebe quando uma página está expondo algo que não deveria. E te deixa melhor como profissional, seja você investigador, desenvolvedor ou curioso. É um conhecimento que serve todo dia, não só num pentest.
O fio que costura tudo isso é o mesmo que eu repito em cada desafio: pensar em possibilidades. Uma URL revela o usuário, o sistema, as pastas, os parâmetros. A partir de hoje, leia e interprete cada endereço, e você vai enxergar informação onde antes via só um link.
Ferramentas e Referências Citadas Neste Aulão
| Ferramenta / Recurso | Para que serve | Link |
|---|---|---|
| URI (MDN) | Referência da estrutura de uma URL | developer.mozilla.org |
| can-i-take-over-xyz | Catálogo de serviços vulneráveis a subdomain takeover | github.com/EdOverflow |
| OWASP Path Traversal | Explicação e defesa contra travessia de diretório | owasp.org |
| OWASP: prevenção de IDOR | Como proteger objetos acessados por ID | cheatsheetseries.owasp.org |
| HackerOne | Plataforma de bug bounty | hackerone.com |
| Burp Suite | Ver e alterar requisições além da URL | portswigger.net |
Perguntas Frequentes
Quais são as partes de uma URL?
Uma URL tem protocolo (HTTPS), subdomínio, domínio de segundo nível, domínio de topo (.com, .br), o caminho de pastas e arquivos, e os parâmetros de query string, que vêm depois da interrogação. Cada parte carrega uma informação diferente sobre o site.
O que os parâmetros de uma URL revelam numa investigação?
Os parâmetros após a interrogação são valores enviados para a aplicação e muitas vezes interpretados pelo servidor. Eles expõem a lógica de negócio, IDs de objetos e datas, e revelam falhas quando a aplicação não valida esses valores no servidor.
O que é subdomain takeover?
É quando um subdomínio aponta, via DNS, para um serviço externo que foi cancelado. Como o apontamento ficou órfão, outra pessoa cria uma conta naquele serviço e reivindica o subdomínio, passando a controlá-lo. A defesa é remover o apontamento assim que parar de usar o serviço.
Como sei qual tecnologia um site usa só pela URL?
Certos caminhos e nomes denunciam a tecnologia. Um wp-content ou wp-admin indica WordPress; um C:\ no caminho sugere Windows; extensões e pastas padrão revelam o software. A partir da tecnologia, você conhece as páginas e falhas padrão dela.
O que é a falha de IDOR na URL?
IDOR (referência insegura a objeto direto) acontece quando uma URL identifica um objeto por um ID (como id=1) e a aplicação não checa se o usuário tem permissão. Trocar o ID dá acesso ao objeto de outro usuário. A prevenção é validar a permissão a cada acesso.
Interpretar URL é uma técnica de ataque ou de defesa?
As duas. O investigador lê a URL para descobrir a estrutura e as falhas de um alvo; o desenvolvedor lê a mesma URL para entender por onde precisa validar e proteger a aplicação. É o mesmo conhecimento aplicado com propósitos opostos.
Dá para achar sites parecidos pelo padrão da URL?
Sim. Um parâmetro ou caminho característico de um software pode ser pesquisado no Google como uma dork, retornando os sites que usam a mesma estrutura de URL. É uma forma de mapear quem roda determinada tecnologia.
Veja também: Câmeras Escondidas na Sua Rede: Como Achar e Se Proteger — Aulão #068
Veja também: O arsenal que eu abro toda semana para investigar (e blindar — Aulão #069
Referências e Recursos
Conteudo Relacionado
Desafio de Investigação Digital ao Vivo: Como Rastreamos um Golpista do Pix em 1h45
Como Encontrar Subdomínios Escondidos: Do DNSDumpster ao Brute Force
Programação do Zero para Investigação Digital: De Variáveis a WHOIS Automatizado